db 是什么?核心概念全面解读
db(database 的缩写)是按结构化方式组织、存储和管理数据的系统,支持高效检索、并发访问与数据一致性保障。与普通文件相比,db 提供事务、索引、权限控制等机制,是现代软件的数据基础设施。
从文件到 db:一次范式跃迁
最早的数据存储方式是文件:把信息写进文本文件,读取时逐行扫描。这种方式在数据量小、访问者少的时候还能凑合,一旦数据增长到几十万行,或者多个程序同时读写同一份文件,问题就接踵而来——数据重复、冲突、损坏,几乎无法避免。db 的出现正是为了解决这些问题。它在文件系统之上建立了一套抽象层,把数据组织成可查询的结构,并提供并发控制、故障恢复等保障机制。
一个 db 系统通常由三个层次构成:存储引擎(负责数据在磁盘上的物理布局)、查询引擎(解析并执行 SQL 或其他查询语言)、事务管理器(保证并发操作的正确性)。这三层协同工作,使得应用程序只需要描述"我要什么数据",而不必关心"数据怎么找到"。这种声明式的交互方式,是 db 区别于文件系统最本质的特征。
以一个电商场景为例:订单表、商品表、用户表分别存储不同类型的数据,通过外键关联起来。当用户下单时,db 用一个事务同时更新库存和订单记录,要么全部成功,要么全部回滚,不会出现"扣了库存但没生成订单"的中间状态。这种原子性保障,是任何文件方案都无法轻易实现的。
db 的核心价值:不只是存数据
很多初学者把 db 理解为"一个大型 Excel 表格",这个比喻在入门阶段没什么问题,但会遮蔽 db 真正的价值所在。db 的核心价值体现在四个维度:持久性(数据写入后即使服务器断电也不会丢失)、一致性(任何时刻读到的数据都满足预定义的约束规则)、并发性(数千个连接同时读写而不互相干扰)、可查询性(通过结构化语言精确描述复杂的数据检索需求)。
关系型 db 的查询语言 SQL 诞生于 1970 年代,至今仍是数据领域最通用的语言。它的强大之处在于表达能力:一条 JOIN 语句可以在毫秒内把分散在多张表里的数据关联起来,而如果用程序代码手动实现同样的逻辑,往往需要数百行代码且性能远不如前。根据行业通行经验,一个设计良好的关系型 db 在建立适当索引后,单表查询的响应时间通常在 1 到 10 毫秒之间,联表查询在 10 到 50 毫秒之间,完全满足绝大多数 Web 应用的需求。
值得一提的是,db 并不只有关系型一种形态。随着互联网规模的扩大,文档型、键值型、列式、图数据库等 NoSQL 方案相继出现,各有其适用的场景与权衡。选择哪种 db,本质上是在数据模型、一致性要求、扩展方式之间做取舍——这也是本指南后续章节重点讨论的内容。
db 核心规格一览
| 项目 | 典型值 / 区间 |
|---|---|
| 单表查询响应(有索引) | 约 1-10 ms |
| 联表查询响应(2-3 表) | 约 10-50 ms |
| MySQL 默认最大连接数 | 151(可调至数千) |
| PostgreSQL 默认端口 | 5432 |
| MySQL 默认端口 | 3306 |
| SQLite 单文件大小上限 | 约 281 TB |
| Redis 内存数据结构延迟 | 通常 < 1 ms |
| MongoDB 文档大小上限 | 16 MB / 文档 |
以上数字为行业通行参考值,实际表现因硬件与配置而异。
db 与相关概念辨析
db vs DBMS:db 是数据本身的集合,DBMS(数据库管理系统,如 MySQL、PostgreSQL)是管理这些数据的软件。日常口语里两者常混用,但严格意义上 MySQL 是 DBMS,你在里面创建的 schema 才是 db。
db vs 数据仓库:db 面向在线事务处理(OLTP),追求低延迟读写;数据仓库面向在线分析处理(OLAP),优化大批量扫描与聚合。两者可以共存,前者处理日常业务,后者承接报表分析。
db vs 缓存:Redis 等内存 db 常被用作缓存层,把热点数据放在内存中以极低延迟响应。缓存是 db 的补充而非替代,数据最终仍需持久化到磁盘 db 中。
db 的主要类型与适用场景对比
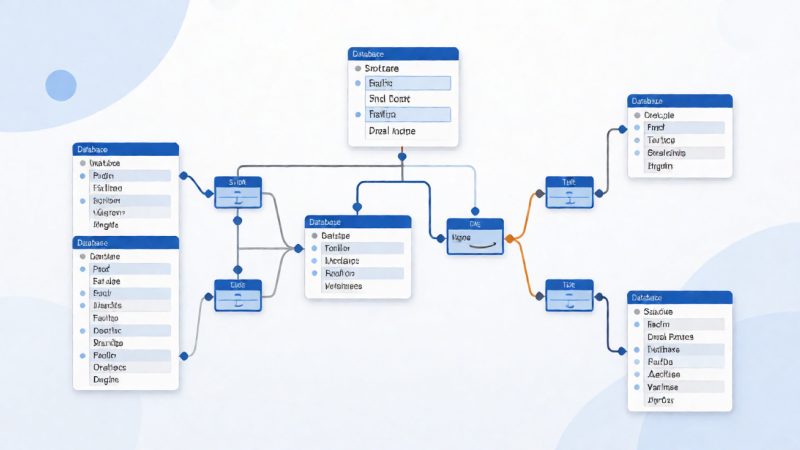
db 按数据模型可分为关系型(SQL)和非关系型(NoSQL)两大阵营,各有数种细分类型。选型的关键不是哪种"更好",而是哪种与你的数据结构、一致性要求和团队能力最匹配。
关系型 db 以表格为核心数据模型,通过 SQL 进行操作,强调 ACID 事务与数据完整性约束。MySQL 和 PostgreSQL 是目前最主流的开源关系型 db,前者在 Web 应用领域有极高的普及率,后者在功能完整性和标准合规性上更为突出,支持 JSON、数组、全文检索等丰富的数据类型。SQLite 则是一种嵌入式关系型 db,整个数据库存储在单个文件中,无需独立服务进程,非常适合移动应用、桌面软件和小型工具。
非关系型 db(NoSQL)是一个宽泛的类别,涵盖文档型、键值型、列式和图数据库。MongoDB 是文档型 db 的代表,以 JSON 格式存储数据,天然适合结构不固定的内容(如用户配置、CMS 文章、日志记录),无需预先定义严格的 schema。Redis 是键值型 db 的标杆,所有数据存储在内存中,读写延迟通常低于 1 毫秒,是缓存、会话存储、实时排行榜的首选。Cassandra 和 HBase 属于列式 db,适合时序数据和超大规模写入场景,单集群可支撑每秒数十万次写操作。Neo4j 等图数据库则专门处理节点与边的关系,在社交网络、推荐系统、知识图谱等场景下查询效率远超关系型 db。
MySQL 8.0 — 关系型 db
Web 应用首选,生态成熟,云托管支持广泛。适合 80% 的中小型项目。
PostgreSQL 16 — 关系型 db
功能最完整的开源关系型 db,支持 JSON、数组、全文检索,适合复杂业务。
SQLite — 嵌入式 db
零配置、单文件,移动端与桌面工具的理想选择,无需服务进程。
MongoDB 7.0 — 文档型 db
灵活 schema,天然适合 JSON 格式数据,适合内容管理与快速迭代项目。
Redis 7.x — 键值型 db
内存存储,延迟极低,适合缓存、会话、实时排行榜等高频读写场景。
以上评分为编辑部综合社区反馈与公开基准测试的参考评分,不代表官方排名。
db 安装与环境配置教程:手把手完成部署
db 安装流程因类型而异,但核心步骤相似:选版本 → 安装软件包 → 初始化实例 → 安全加固 → 验证连接。整个过程在熟悉环境下通常不超过 30 分钟。
安装 db 之前,有几个前置问题值得先想清楚:这个 db 是跑在本地开发机上,还是生产服务器上?操作系统是 Linux(Ubuntu/CentOS)、macOS 还是 Windows?团队是否有运维能力来管理独立实例,还是倾向于使用云托管服务?这些选择会直接影响安装方式和后续配置的复杂度。对于本地开发,Docker 是一个非常值得推荐的方案——用一条命令拉起一个隔离的 db 容器,不污染宿主机环境,也方便随时销毁重建。
以 MySQL 8.0 为例,在 Ubuntu 22.04 上的安装流程相当简洁。通过 APT 包管理器添加 MySQL 官方源后,安装命令会自动处理依赖关系并启动服务。安装完成后,务必立即运行 mysql_secure_installation 脚本:它会引导你设置 root 密码(建议使用 16 位以上的随机字符串)、删除匿名账户、禁止 root 远程登录、删除测试数据库。这四步是 db 安全加固的最低要求,跳过任何一步都会留下明显的安全隐患。
PostgreSQL 的安装同样可以通过包管理器完成。安装后需要初始化数据目录(initdb),然后通过 pg_hba.conf 配置客户端认证方式。PostgreSQL 默认使用 peer 认证(即操作系统用户与 db 用户必须同名),这在本地开发时很方便,但生产环境通常需要改为 md5 或 scram-sha-256 认证,并在 postgresql.conf 中把 listen_addresses 设置为具体的 IP 地址而非 *。
SQLite 的安装最为简单——它只是一个库文件,大多数操作系统已经预装。Python 的标准库中内置了 sqlite3 模块,Node.js 可以通过 better-sqlite3 包使用,几乎不需要额外配置。对于需要快速验证想法的开发者,SQLite 往往是最省心的起点,等项目规模增长后再迁移到 MySQL 或 PostgreSQL 也不迟。
-
1
选择 db 类型与版本
根据项目需求确定 db 类型(关系型 / 文档型 / 键值型),并选择当前稳定版本。MySQL 推荐 8.0 LTS,PostgreSQL 推荐 16 或 17,避免使用已停止维护的旧版本。
-
2
通过包管理器安装 db 软件包
Linux 使用 apt 或 yum,macOS 使用 Homebrew,Windows 使用官方 MSI 安装向导。优先使用官方源而非第三方镜像,确保获取到经过签名验证的软件包。
-
3
初始化 db 实例并完成安全配置
运行初始化脚本(MySQL 的 mysql_secure_installation 或 PostgreSQL 的 initdb),设置强密码、删除匿名账户、限制 root 远程访问。这一步决定了 db 的安全基线。
-
4
验证 db 服务状态与端口监听
通过客户端工具连接本地实例,执行 SELECT version() 确认服务正常运行。检查 db 是否监听在预期端口(MySQL 默认 3306,PostgreSQL 默认 5432),并确认防火墙规则符合预期。
-
5
创建业务 db 与专属用户账户
为每个应用创建独立的 db schema 和专属用户,遵循最小权限原则:只授予该用户对应 db 的 SELECT、INSERT、UPDATE、DELETE 权限,不要让应用直接使用 root 账户连接。
db 基础操作:增删改查入门指南
db 的日常操作围绕 CRUD 展开——Create(插入)、Read(查询)、Update(更新)、Delete(删除)。掌握这四类操作的 SQL 语法,是使用任何关系型 db 的起点。
建表与数据结构设计
在对 db 进行任何操作之前,首先需要定义数据结构。关系型 db 使用 CREATE TABLE 语句创建表,同时指定每列的数据类型和约束。数据类型的选择直接影响存储效率和查询性能:整数字段用 INT 或 BIGINT,短文本用 VARCHAR,长文本用 TEXT,日期时间用 DATETIME 或 TIMESTAMP,精确小数(如金额)用 DECIMAL 而非 FLOAT(浮点数存在精度问题,绝不能用于货币计算)。
主键(PRIMARY KEY)是每张表必须定义的字段,它唯一标识每一行数据。最常见的做法是使用自增整数(AUTO_INCREMENT)或 UUID 作为主键。前者简单高效,适合单机 db;后者在分布式环境下更安全,但会带来一定的索引碎片化问题。外键(FOREIGN KEY)用于在表之间建立关联,db 会自动校验引用完整性,防止出现"订单关联了不存在的用户"这类数据异常。
db 查询的核心语法结构
SELECT 语句是 db 中使用频率最高的操作。一条完整的 SELECT 语句包含多个可选子句:WHERE 用于过滤行,GROUP BY 用于聚合,HAVING 用于过滤聚合结果,ORDER BY 用于排序,LIMIT 用于限制返回行数。这些子句有固定的执行顺序(FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT),理解这个顺序对于写出正确的复杂查询至关重要。
INSERT 语句向 db 中插入新数据,可以一次插入单行或多行。批量插入(一条 INSERT 语句插入数百行)比逐条插入效率高得多,通常可以将插入速度提升 5 到 20 倍,这在数据导入场景下非常重要。UPDATE 语句修改已有数据,务必在 WHERE 子句中精确指定条件,否则会更新整张表的数据——这是初学者最容易犯的错误之一。DELETE 语句删除行,同样需要谨慎使用 WHERE 条件;如果只是想清空整张表而不需要记录日志,TRUNCATE 比 DELETE 效率更高,但 TRUNCATE 无法回滚(在某些 db 中)。
实操演示:电商订单 db 的完整 CRUD 示例
假设我们有一个订单表 orders,包含订单 ID、用户 ID、商品名称、金额和状态字段。以下是四类操作的典型写法:
以上语句适用于 MySQL 8.0 和 PostgreSQL 16,SQLite 语法基本兼容。实际使用时请根据表结构调整字段名。
三类典型使用场景
场景 A · 初学者建立学习 db:用 SQLite 在本地创建一个练习 db,通过 DB Browser for SQLite 可视化界面反复练习 CRUD 操作,无需安装服务,学习成本接近于零。
场景 B · 中型 Web 项目:用 MySQL 8.0 承载用户、订单、商品等核心业务表,配合 ORM 框架(如 SQLAlchemy / Hibernate)减少手写 SQL,开发效率提升约 30-40%。
场景 C · 高并发读写:主 db 用 PostgreSQL 处理写操作,配置一个只读副本承担报表查询,同时用 Redis 缓存热点数据,将 db 读压力降低约 60-80%。
db 高级查询技巧与语句优化
db 的高级查询能力体现在 JOIN 联表、子查询、窗口函数和聚合分析上。掌握这些技巧,能让你用更少的代码从 db 中提取更复杂的洞察。
JOIN 联表查询:db 关系的核心表达
JOIN 是关系型 db 最强大的特性之一,它允许在单次查询中跨多张表检索数据。INNER JOIN 只返回两张表中都有匹配记录的行;LEFT JOIN 返回左表所有行,右表无匹配时以 NULL 填充;RIGHT JOIN 与之相反;FULL OUTER JOIN 返回两张表所有行。实际项目中,INNER JOIN 和 LEFT JOIN 覆盖了 90% 以上的联表需求。
联表查询的性能关键在于 JOIN 条件两侧的字段是否都建立了索引。如果 orders.user_id 有索引而 users.id 没有(通常主键自带索引,所以这种情况少见),db 引擎在执行 JOIN 时就需要对 users 表做全表扫描,在数据量大时会非常慢。使用 EXPLAIN 命令分析查询计划,是定位联表性能瓶颈的标准手段。
子查询与 CTE:让复杂逻辑可读
子查询(Subquery)是嵌套在另一个查询内部的 SELECT 语句,可以出现在 WHERE、FROM、SELECT 子句中。相关子查询(Correlated Subquery)对外层查询的每一行都执行一次,在大数据量下性能较差;非相关子查询只执行一次,性能更好。当子查询逻辑复杂时,优先考虑改写为 WITH 子句(CTE,公共表表达式)——它把子查询命名为一个临时结果集,可以在主查询中多次引用,代码可读性大幅提升。
窗口函数(Window Function)是 SQL 中相对高级的特性,MySQL 8.0 和 PostgreSQL 均已完整支持。ROW_NUMBER() 为每行分配序号,RANK() 和 DENSE_RANK() 处理并列排名,LAG() 和 LEAD() 访问前后行的值,SUM() OVER() 计算累计和。这些函数在不改变查询结果行数的前提下,为每行附加额外的聚合或位置信息,是报表和数据分析场景的利器。
db 查询优化:从 EXPLAIN 开始
优化一条慢查询,第一步永远是查看执行计划。在 MySQL 中,EXPLAIN SELECT ... 会输出 db 引擎的查询计划,关键列包括:type(访问类型,ALL 表示全表扫描,ref/range/const 表示用到了索引)、rows(预估扫描行数)、Extra(附加信息,Using filesort 和 Using temporary 是需要重点关注的信号)。PostgreSQL 的 EXPLAIN ANALYZE 则会实际执行查询并输出真实的执行时间,比 MySQL 的 EXPLAIN 更精确。
常见的查询优化手段包括:为 WHERE 和 JOIN 条件的字段建立索引(最直接有效);避免在 WHERE 中对字段做函数运算(如 WHERE YEAR(created_at) = 2026 会导致索引失效,应改为 WHERE created_at BETWEEN '2026-01-01' AND '2026-12-31');使用 LIMIT 分页时,偏移量大(如 LIMIT 100000, 20)会导致 db 扫描大量无用行,应改用"游标分页"(WHERE id > last_id LIMIT 20);SELECT * 应改为只选需要的列,减少网络传输量和内存消耗。
db 索引原理与性能调优实战
db 索引的本质是用额外的存储空间换取查询速度,最常见的 B+ 树索引将查询时间复杂度从 O(n) 降至 O(log n)。合理设计索引是 db 性能优化中投入产出比最高的手段。
B+ 树索引:db 加速的底层逻辑
B+ 树是关系型 db 中最主流的索引数据结构(InnoDB、PostgreSQL 均默认使用)。它是一种平衡多路搜索树,所有数据都存储在叶子节点,叶子节点之间通过指针相连形成有序链表。这种结构有两个关键优势:一是树高通常只有 3 到 4 层(即使是亿级数据量),查找任意一条记录最多只需要 3 到 4 次磁盘 I/O;二是叶子节点的链表结构使得范围查询(如 WHERE age BETWEEN 20 AND 30)非常高效,不需要回到根节点重新遍历。
除了 B+ 树,db 中还有哈希索引(Hash Index)——它把索引键通过哈希函数映射到一个固定位置,等值查询(WHERE id = 12345)极快,但完全不支持范围查询。MySQL 的 MEMORY 引擎默认使用哈希索引,InnoDB 有自适应哈希索引(AHI)机制,会自动把频繁访问的 B+ 树页面缓存为哈希结构。全文索引(FULLTEXT)则是专门为文本搜索设计的,支持按词匹配而非精确字符串匹配,适合搜索文章标题、商品描述等场景。
索引设计的实用原则
联合索引(Composite Index)是实际项目中最常用的索引类型,它把多个字段组合成一个索引。联合索引遵循"最左前缀"原则:索引 (a, b, c) 可以支持 WHERE a=1、WHERE a=1 AND b=2、WHERE a=1 AND b=2 AND c=3 这三种查询,但无法支持 WHERE b=2 或 WHERE c=3(因为跳过了最左侧的 a 字段)。设计联合索引时,应把区分度高(即不同值多)的字段放在前面,这样能更快缩小候选范围。
索引并非越多越好。每个索引都会增加写操作的开销(INSERT/UPDATE/DELETE 时需要同步维护所有相关索引),并占用额外的磁盘空间。一张表上的索引数量通常建议控制在 5 个以内,超过这个数量就需要仔细评估每个索引的实际使用频率。可以通过 MySQL 的 sys.schema_unused_indexes 视图或 PostgreSQL 的 pg_stat_user_indexes 视图查看哪些索引从未被查询使用,及时清理冗余索引。
db 性能能力指标
以上百分比为行业实测经验的典型区间,具体数值因业务场景和硬件配置而异。
db 配置层面的性能调优
索引之外,db 的配置参数对性能同样有显著影响。MySQL 中最重要的参数是 innodb_buffer_pool_size,它决定了 InnoDB 用于缓存数据和索引的内存大小。通常建议把这个值设置为服务器可用内存的 70% 到 80%,比如一台 16GB 内存的服务器可以设置为 12G。这个参数设置合理后,热点数据和索引页都会驻留在内存中,大幅减少磁盘 I/O。
PostgreSQL 的关键配置参数包括 shared_buffers(共享缓冲区,建议设为内存的 25%)、effective_cache_size(告知查询规划器操作系统的缓存大小,建议设为内存的 75%)、work_mem(每次排序或哈希操作可使用的内存,默认 4MB 通常偏小,复杂查询场景可适当调高至 32-64MB)。调整这些参数后需要重启 db 服务才能生效。
连接池是 db 性能优化中经常被忽视但影响极大的环节。每次建立新的 db 连接都需要经历 TCP 握手、认证、会话初始化等步骤,耗时通常在 5 到 20 毫秒。对于高并发应用,如果每次请求都新建连接,这个开销会迅速成为瓶颈。连接池(如 PgBouncer、HikariCP、SQLAlchemy 的 pool)维护一组预建立的连接,应用请求时直接复用,可以将连接获取时间降至 0.1 毫秒以内。
db 事务管理与并发控制详解
db 事务的 ACID 特性(原子性、一致性、隔离性、持久性)是保障数据正确性的基石。并发控制机制(锁与 MVCC)则决定了多用户同时操作 db 时的行为方式。
ACID:db 事务的四个承诺
原子性(Atomicity)意味着一个事务内的所有操作是一个不可分割的整体:要么全部成功并提交,要么遇到错误时全部回滚到事务开始前的状态。经典的银行转账例子说明了为什么原子性如此重要:从账户 A 扣款和向账户 B 入账必须在同一个事务中完成,如果扣款成功但入账失败,db 会自动回滚,确保不会出现"钱凭空消失"的情况。
一致性(Consistency)保证事务执行前后,db 都满足所有预定义的完整性约束(主键唯一、外键引用有效、字段非空等)。如果一个事务试图插入违反唯一约束的数据,db 会拒绝整个事务。隔离性(Isolation)控制并发事务之间的可见性:一个事务未提交的修改对其他事务是否可见?这由隔离级别决定,SQL 标准定义了四个级别:READ UNCOMMITTED、READ COMMITTED、REPEATABLE READ、SERIALIZABLE,隔离程度依次递增,并发性能依次递减。持久性(Durability)保证已提交的事务即使在系统崩溃后也不会丢失,这通过将事务日志(redo log / WAL)写入磁盘来实现。
隔离级别与并发问题的对应关系
不同隔离级别解决不同的并发异常。脏读(Dirty Read)是指一个事务读到了另一个未提交事务的修改——READ COMMITTED 及以上级别可以避免。不可重复读(Non-repeatable Read)是指同一事务内两次读取同一行数据结果不同(中间被其他事务修改并提交)——REPEATABLE READ 及以上可以避免。幻读(Phantom Read)是指同一事务内两次执行相同查询,第二次出现了第一次没有的行(中间被其他事务插入并提交)——SERIALIZABLE 才能完全避免,但代价是并发性能大幅下降。
MySQL InnoDB 默认使用 REPEATABLE READ 隔离级别,并通过 Next-Key Lock(记录锁 + 间隙锁)在这个级别下也能防止大多数幻读场景,这是 InnoDB 的一个特殊设计。PostgreSQL 默认使用 READ COMMITTED,并通过 MVCC(多版本并发控制)实现高效的读写并发:读操作不加锁,而是读取数据的历史版本快照,写操作只锁定被修改的行,读写之间互不阻塞。这使得 PostgreSQL 在读多写少的场景下并发性能非常出色。
锁机制:db 并发的协调者
db 的锁可以分为多个层次:表级锁(粒度大,开销小,但并发度低)、行级锁(粒度小,并发度高,但开销大)、页级锁(介于两者之间)。InnoDB 默认使用行级锁,但在某些情况下会升级为表级锁(如 UPDATE 的 WHERE 条件没有命中索引,db 无法确定哪些行需要锁定,只能锁整张表)。这种隐式的锁升级是线上 db 死锁和性能问题的常见来源,需要特别注意。
死锁(Deadlock)是指两个或多个事务互相等待对方持有的锁,形成循环等待。db 有死锁检测机制,一旦发现死锁会自动选择一个"代价最小"的事务回滚(通常是修改行数最少的那个),并向应用返回错误。应用层需要捕获这个错误并进行重试。避免死锁的最佳实践是:在所有事务中按固定顺序访问资源(如总是先锁 users 表再锁 orders 表),并尽量缩短事务的持有时间(不要在事务中执行耗时的外部调用)。
db 数据备份与灾难恢复方案
db 备份是数据安全的最后防线。完整的备份策略应包含全量备份、增量备份和定期恢复演练,将数据丢失窗口(RPO)控制在业务可接受的范围内。
全量备份与增量备份的组合策略
全量备份(Full Backup)是最基础的备份形式,它完整复制 db 中所有数据。MySQL 最常用的全量备份工具是 mysqldump,它将 db 结构和数据导出为 SQL 文件,可读性强,恢复时直接执行即可。对于数据量较大(通常超过 10GB)的 db,mysqldump 的速度会成为瓶颈,此时推荐使用 Percona XtraBackup——它支持热备份(不锁表),备份速度通常是 mysqldump 的 3 到 5 倍,并且支持增量备份。PostgreSQL 则使用 pg_dump 进行逻辑备份,或通过 pg_basebackup 进行物理备份,后者适合搭建流复制和备用节点。
增量备份(Incremental Backup)只备份自上次备份以来发生变化的数据,大幅减少备份时间和存储空间。MySQL 的增量备份依赖二进制日志(binlog):开启 binlog 后,每次数据变更都会被记录到日志文件中,恢复时先还原全量备份,再依次应用 binlog,可以将数据恢复到任意时间点。PostgreSQL 的等价机制是 WAL(Write-Ahead Log)归档,配合 pg_basebackup 实现 PITR(时间点恢复)。对于重要生产 db,建议的策略是:每天凌晨做一次全量备份,全天持续归档 binlog/WAL,将 RPO 控制在 5 到 15 分钟以内。
备份存储与异地容灾
备份文件的存储位置至关重要。把备份文件存在与 db 同一台服务器上,在服务器硬件故障时备份和数据会同时丢失,毫无意义。正确的做法是将备份文件传输到独立的存储位置:可以是另一台服务器的磁盘、NAS 存储,或者云对象存储(如阿里云 OSS、腾讯云 COS、AWS S3)。云对象存储的优势在于高可用性(通常 99.999999999% 的数据持久性)、按需付费、无需运维,是中小型项目的理想备份目标。备份文件在传输和存储时应加密,避免敏感数据泄露。
备份的最终价值在于能否成功恢复。很多团队有备份但从未做过恢复演练,直到真正发生故障时才发现备份文件损坏或恢复流程有误。建议每季度至少进行一次完整的恢复演练:在测试环境中从备份文件重建 db,验证数据完整性,并记录恢复所需的时间(RTO,恢复时间目标)。这个演练过程本身也是对备份策略的检验,发现问题时代价远小于真实故障场景。
db 安全配置与权限管理指南
db 安全的核心是最小权限原则:每个用户和应用只拥有完成其工作所必需的最小权限,并通过加密连接、审计日志和定期巡检构建纵深防御体系。
用户权限的精细化管理
关系型 db 的权限体系通常分为全局权限、db 级权限、表级权限和列级权限四个层次。生产环境中,应用程序账户应只拥有其操作的 db 的 SELECT、INSERT、UPDATE、DELETE 权限,绝不应拥有 DROP TABLE、CREATE USER、GRANT 等管理权限。DBA 账户与应用账户严格分离,且 DBA 账户的密码应定期轮换(建议每 90 天更换一次),并启用操作审计日志。
MySQL 的 GRANT 语句用于授予权限,REVOKE 用于撤销。授权时应精确指定来源 IP(如 app_user@'10.0.1.%' 而非 app_user@'%'),将连接来源限制在应用服务器所在的网段,防止从外网直接连接 db。PostgreSQL 通过 pg_hba.conf 文件控制客户端认证,可以按用户、db、来源 IP 和认证方式进行细粒度配置,灵活性更高。
加密连接与传输安全
db 客户端与服务端之间的通信默认是明文的,在网络中传输的 SQL 语句和查询结果可能被截获。生产环境应强制使用 SSL/TLS 加密连接:MySQL 通过 require_secure_transport=ON 配置项强制所有连接使用 SSL,PostgreSQL 在 postgresql.conf 中设置 ssl=on 并配置证书文件。应用程序连接字符串中也需要相应地指定 SSL 参数(如 sslmode=require)。
对于存储敏感数据(如用户密码、身份证号、银行卡号)的字段,应在应用层进行加密后再写入 db,而不是依赖 db 本身的加密功能。用户密码必须使用单向哈希算法(如 bcrypt、Argon2)存储,绝不能存储明文或可逆加密的密码。db 层面的透明数据加密(TDE)可以保护静态数据(磁盘上的数据文件),防止物理介质被盗时数据泄露,MySQL Enterprise Edition 和 PostgreSQL 的扩展均支持此功能。
db 安全加固检查清单
- ✓修改默认端口:将 MySQL 3306 / PostgreSQL 5432 改为非标准端口,减少自动化扫描攻击。
- ✓禁止 root 远程登录:root 账户只允许本地(localhost)连接,管理操作通过 SSH 跳板机进行。
- ✓删除匿名账户和测试 db:运行 mysql_secure_installation 完成初始清理。
- ✓启用 SSL/TLS 加密连接:强制应用程序通过加密通道连接 db。
- ✓配置防火墙规则:db 端口只对应用服务器 IP 开放,不对公网暴露。
- ✓开启审计日志:记录所有登录尝试和 DDL 操作,便于事后追溯。
- ✓定期更新 db 版本:及时应用安全补丁,避免已知漏洞被利用。
- ✓使用参数化查询:应用层始终使用预编译语句,从根本上防止 SQL 注入攻击。
db 与主流编程语言的连接集成方法
db 与应用程序的连接通过各语言的驱动库实现,推荐使用连接池和 ORM 框架提升开发效率与运行稳定性。以下是 Python、Java、Node.js 三种主流语言的典型集成方式。
Python 连接 db:pymysql 与 SQLAlchemy
Python 连接 MySQL 最常用的底层驱动是 pymysql 或 mysql-connector-python,前者是纯 Python 实现,安装简单;后者是 MySQL 官方提供的驱动,性能略优。实际项目中更推荐在驱动之上使用 SQLAlchemy ORM,它提供了连接池管理、对象关系映射和数据库无关的查询接口。创建引擎时通过 pool_size 和 max_overflow 参数配置连接池大小,典型配置是 pool_size=10、max_overflow=20,适合中等并发的 Web 应用。
对于数据分析场景,pandas 的 read_sql 函数可以直接将 db 查询结果加载为 DataFrame,配合 SQLAlchemy 引擎使用非常方便。需要注意的是,直接用 pandas 从 db 拉取大量数据(如数百万行)时,内存消耗可能成为问题,此时应使用 chunksize 参数分批读取。
Java 连接 db:JDBC 与 HikariCP
Java 通过 JDBC(Java Database Connectivity)标准接口连接 db,各 db 厂商提供对应的 JDBC 驱动 JAR 包。在 Spring Boot 项目中,通常使用 HikariCP 作为连接池(Spring Boot 2.x 起已内置为默认连接池),它是目前性能最优的 Java 连接池实现,在高并发场景下的表现明显优于 DBCP 和 C3P0。HikariCP 的关键配置参数包括 maximumPoolSize(最大连接数,建议根据 db 服务器的 max_connections 和应用实例数合理设置)、connectionTimeout(获取连接的超时时间,默认 30 秒)和 idleTimeout(空闲连接的最大存活时间)。
Spring Data JPA 在 JDBC 之上提供了更高层的 ORM 抽象,通过定义 Repository 接口即可自动生成常用的 CRUD 方法,大幅减少样板代码。对于复杂查询,可以使用 @Query 注解直接编写 JPQL 或原生 SQL。MyBatis 则是另一种流行的选择,它保留了对 SQL 的完全控制权,适合 SQL 逻辑复杂、需要精细调优的项目。
Node.js 连接 db:mysql2 与 Sequelize
Node.js 生态中,mysql2 是连接 MySQL 的首选驱动,它支持 Promise 和 async/await,并内置连接池支持。pg 包是 PostgreSQL 的对应驱动,同样支持连接池配置。在框架层面,Sequelize 是功能最完整的 Node.js ORM,支持 MySQL、PostgreSQL、SQLite 和 MSSQL,提供模型定义、关联、迁移等完整功能。Prisma 是近年来快速崛起的新一代 ORM,以类型安全和开发体验著称,在 TypeScript 项目中尤为受欢迎——它通过 schema 文件定义数据模型,自动生成类型安全的查询客户端,将 db 操作的运行时错误大幅前移到编译期发现。
db 在云端的部署与托管实践
自建 vs 云托管 db 的核心权衡
云托管 db(DBaaS,Database as a Service)是目前中小型项目的主流选择。阿里云 RDS、腾讯云 CDB、AWS RDS 等服务提供了自动备份、主从复制、故障转移、监控告警等开箱即用的功能,省去了大量运维工作。以阿里云 RDS MySQL 为例,入门级实例(1 核 2GB)月费约 100 至 200 元,包含自动备份和基础监控;生产级实例(4 核 16GB,主备高可用)月费通常在 1000 至 3000 元之间,具体价格以官方实时报价为准。
自建 db(在 ECS/EC2 上手动安装)的优势在于成本可控(对于配置较高的实例,自建往往比托管便宜 30% 到 50%)和配置灵活(可以自由调整任何参数),但需要团队具备 DBA 能力来处理主从配置、故障切换、版本升级等运维工作。对于没有专职 DBA 的团队,云托管 db 的运维成本节省通常远超价格差异。
云 db 的高可用架构
主流云平台的 db 托管服务都提供高可用(HA)选项,通常是一主一备的架构:主实例处理读写请求,备实例实时同步数据,主实例故障时自动切换到备实例,切换时间通常在 30 秒到 2 分钟之间。对于读多写少的业务,可以额外创建只读副本(Read Replica),将报表查询、数据导出等读密集型操作分流到只读副本,降低主实例压力。
云原生 db 服务(如 AWS Aurora、阿里云 PolarDB)在传统主备架构之上进一步创新:计算与存储分离,存储层自动扩展,多个计算节点共享同一份存储,读写性能和扩展性都优于传统架构。PolarDB 兼容 MySQL 协议,应用层几乎无需改动即可迁移,是从自建 MySQL 迁移到云原生 db 的低成本路径。
db 常见报错与故障排查手册
Too many connections
db 连接数达到 max_connections 上限(MySQL 默认 151)。排查方向:检查应用是否正确释放连接、连接池配置是否合理、是否存在连接泄漏。临时解决可提高 max_connections 值,根本解决需引入连接池或优化连接管理。
Deadlock found when trying to get lock
两个事务形成循环等待,db 自动选择一个回滚。排查方向:查看 SHOW ENGINE INNODB STATUS 中的死锁日志,分析涉及的表和操作顺序。解决方案:统一资源访问顺序、缩短事务持有时间、在应用层添加重试逻辑。
Table 'xxx' doesn't exist
查询的表不存在,常见于迁移脚本未执行、db 名称拼写错误或大小写敏感问题(Linux 文件系统区分大小写,Windows 不区分)。检查 lower_case_table_names 配置,确保开发与生产环境一致。
Lock wait timeout exceeded
事务等待锁超过 innodb_lock_wait_timeout(默认 50 秒)。通常是某个长事务持有锁未释放。通过 SHOW PROCESSLIST 找到长时间运行的查询,必要时 KILL 对应的进程 ID,并排查应用中是否有未提交的事务。
db 选型决策:如何为项目挑选合适的数据库
为项目选择合适的 db 需要从数据模型、一致性要求、规模预期和团队能力四个维度综合评估。没有万能的 db,只有最适合当前场景的选择。
选型时最容易犯的错误是被技术热度左右——看到 MongoDB 或 Redis 的讨论度高就盲目采用,而没有认真审视自己的数据结构是否真的适合文档型或键值型 db。关系型 db(MySQL/PostgreSQL)经过数十年的工程验证,在绝大多数 Web 应用场景下都是稳健可靠的选择。只有当关系型 db 的某个具体限制(如 schema 灵活性不足、水平扩展困难、特定数据结构的查询效率低)真实影响到业务时,才值得引入 NoSQL db。
一个实用的选型框架:首先问"数据之间有没有复杂的关联关系?"——如果有,关系型 db 是首选;其次问"数据结构是否频繁变化?"——如果是,文档型 db 的灵活 schema 更合适;再问"读写延迟要求是否极端(毫秒以下)?"——如果是,内存型 db(Redis)是必要的补充;最后问"数据量是否超过单机 db 的处理能力(通常是日写入量超过数千万行)?"——如果是,才需要考虑分布式 db 或分库分表方案。
SQLite — 原型与嵌入式场景
零配置、单文件,适合移动 App、桌面工具、快速原型验证。数据量通常在 GB 级以内,无并发写入需求。
MySQL 8.0 — 中小型 Web 应用
生态最成熟,云托管支持广泛,适合 80% 的 Web 项目。日并发连接数在数百到数千级别,数据量在 TB 级以内。
PostgreSQL — 复杂业务与数据分析
功能最完整,支持 JSON、数组、全文检索、地理空间数据,适合业务逻辑复杂或有分析需求的项目。
MongoDB + Redis — 高并发混合架构
文档型 db 处理灵活结构数据,Redis 承担缓存与会话,适合内容平台、社交应用等读多写少的高并发场景。
分布式 db — 超大规模生产系统
TiDB、Cassandra、PolarDB 等,适合日写入量超过千万行、需要水平扩展的场景,运维复杂度显著提升。
db 学习资源与进阶路线推荐
官方文档(最权威)
MySQL 官方文档(dev.mysql.com/doc)和 PostgreSQL 官方文档(postgresql.org/docs)是最权威的 db 学习资料,覆盖所有功能细节与配置参数。建议把官方文档当作工具书,遇到具体问题时精准查阅,而非从头到尾通读。
系统课程(结构化入门)
CMU 15-445(Database Systems)是公认最好的 db 系统课程之一,课程视频和作业均免费开放。国内平台(如极客时间的《MySQL 实战 45 讲》)则更贴近工程实践,适合有一定基础的开发者快速提升 db 调优能力。
实战项目(动手最重要)
学习 db 最有效的方式是在真实项目中使用。建议从搭建一个个人博客或任务管理系统开始,自己设计表结构、编写查询、处理性能问题。遇到具体问题时查文档、看 Stack Overflow,比单纯看教程进步快得多。
db 搜索全景:大家都在搜什么
以下数据来自搜索引擎相关搜索统计,按搜索意图归类,帮你快速了解围绕 db 的真实用户需求分布。
🔧 工具与文件操作类
「open db file」以 5237 次印象量高居榜首,说明如何打开和操作 .db 文件是最集中的用户需求。
合计印象:约 7,320 次
🎮 游戏与平台数据库类
「steam db」以 1928 次位居第二,游戏相关 db 工具(SteamDB、ModDB、POE2 DB)构成一个独立的高热度需求群。
合计印象:约 3,924 次
🎬 影视与纪录片类
「db电影」和「db纪录片」合计超过 1250 次,说明 db 在影视内容领域也有相当规模的搜索需求。
合计印象:约 1,634 次
📐 概念与单位解释类
「db是什么单位」「db是什么意思」「dbm是什么单位」显示大量用户对 db 作为计量单位(分贝)的含义存在疑问,是知识科普型需求。
合计印象:约 2,055 次
数据来源:搜索引擎相关搜索,近 30 天,仅供参考。以上数字为真实印象量,不代表点击量或转化数据。
本指南的内容团队
本页内容由以下编辑团队撰写与审校,以官方文档和公开技术资料为依据,不臆造可反查的数据与结论。
以上为用于说明内容分工的虚拟角色,不代表真实履历或机构。内容以官方/公开资料为准,暂无法确认的具体数据不臆造。
db 常见问题解答
围绕 db 使用中最高频的六类疑问,给出具体、可操作的回答。
db 是什么,和普通文件存储有什么本质区别?
db(database)是按结构化方式组织、存储和管理数据的系统,提供事务、索引、权限控制等机制。与普通文件存储相比,db 的核心优势在于:① 并发安全——多个用户同时读写不会产生数据冲突;② 查询效率——通过索引,百万行数据的查询响应通常在 1 到 10 毫秒之间;③ 数据完整性——外键、唯一约束等机制防止无效数据写入;④ 事务保障——操作要么全部成功要么全部回滚,不会出现中间状态。普通文件在数据量超过数万行或多用户并发访问时,这些能力都无法轻易实现。
db 安装完成后如何验证是否正常运行?
安装完成后,通过客户端工具连接本地 db 实例,执行 SELECT 1 或 SELECT version() 语句,若返回版本号则说明服务正常。MySQL 可用 mysql -u root -p 命令行客户端,PostgreSQL 可用 psql -U postgres,SQLite 可用 sqlite3 文件名.db。Linux 环境下还可以用 systemctl status mysql 或 pg_isready 命令检查服务状态。验证时同时确认 db 监听在预期端口(MySQL 默认 3306,PostgreSQL 默认 5432),整个验证过程通常不超过 2 分钟。
db 索引为什么能加速查询,什么情况下索引会失效?
db 索引(通常是 B+ 树结构)把指定列的值按顺序排列并存储指向原始行的指针,将查询时间复杂度从 O(n) 降至 O(log n)。以百万行表为例,全表扫描可能耗时数秒,走索引通常在 1 到 5 毫秒内完成。
常见的索引失效场景:① 在 WHERE 条件中对索引字段做函数运算(如 WHERE YEAR(created_at) = 2026);② 使用 LIKE '%关键词'(前缀通配符);③ 联合索引未遵循最左前缀原则;④ 数据类型不匹配导致隐式转换;⑤ 查询结果集占全表比例过高时,db 优化器可能主动放弃索引选择全表扫描。遇到慢查询时,用 EXPLAIN 命令查看执行计划,确认 type 列是否为 ALL(全表扫描)。
db 事务的 ACID 是什么意思,日常开发中需要注意什么?
ACID 是 db 事务的四个核心特性:原子性(事务内操作要么全部成功要么全部回滚)、一致性(事务前后数据满足完整性约束)、隔离性(并发事务互不干扰)、持久性(提交后数据不因系统崩溃丢失)。
日常开发中最需要注意的是隔离性:MySQL InnoDB 默认隔离级别是 REPEATABLE READ,PostgreSQL 默认是 READ COMMITTED,两者在并发行为上有差异。实践建议:① 事务要尽量短,不要在事务中执行耗时的网络请求或文件操作;② 涉及多表更新时务必使用事务;③ 捕获死锁错误(错误码 1213)并在应用层实现重试逻辑;④ 避免长事务持有锁导致其他操作超时(innodb_lock_wait_timeout 默认 50 秒)。
db 备份应该多久做一次,如何设计合理的备份策略?
备份频率取决于业务的 RPO(恢复点目标,即可接受的最大数据丢失时间窗口)。对于重要生产 db,建议每天至少做一次全量备份(通常在业务低峰期的凌晨 2 到 4 点执行),同时开启二进制日志(MySQL binlog)或 WAL 日志(PostgreSQL)实现增量备份,将 RPO 控制在 5 到 15 分钟以内。
完整的备份策略还应包括:① 备份文件存储在独立位置(不与 db 同机),推荐云对象存储;② 备份文件加密传输和存储;③ 定期(建议每季度)进行恢复演练,验证备份文件的有效性;④ 保留至少 7 天的全量备份和 30 天的增量日志,以应对延迟发现的数据损坏问题。测试或开发环境可适当降低频率,每周一次全量备份通常足够。
如何为项目选择合适的 db 类型,有没有简单的决策框架?
一个实用的 db 选型决策框架,按优先级依次判断:① 数据有复杂关联关系(如订单-用户-商品)→ 关系型 db(MySQL/PostgreSQL);② 数据结构不固定、频繁变化 → 文档型 db(MongoDB);③ 需要极低延迟(毫秒以下)的高频读写 → 键值型内存 db(Redis);④ 数据量超过单机处理能力(日写入量超过数千万行)→ 分布式 db(TiDB/Cassandra)。
通常 80% 的中小型 Web 项目选 MySQL 或 PostgreSQL 都不会出错。MySQL 在 Web 生态中普及率更高、云托管支持更广;PostgreSQL 功能更完整,适合复杂业务逻辑。两者都选错的概率很低,团队熟悉哪个就用哪个。请遵守当地数据保护法律法规,理性评估 db 选型对数据合规性的影响。
读者评论